Resumen
BENCH-2026-11 es el benchmark oficial de vericto-proxy: dos instancias EC2 dedicadas, la ruta directa a la base medida en la misma corrida, tres repeticiones intercaladas y una repetición en otro día sobre hosts nuevos. Las cifras, con sus condiciones:
- PostgreSQL (pgbench select-only, protocolo extendido, una sentencia por request): el proxy agregó 0,12 ms en la mediana de 603 a 3.016 sentencias/s, y 0,14 ms a 4.223/s. La ruta directa tardó de 0,29 a 0,31 ms en la mediana.
- MySQL (sysbench oltp_read_only, 16 sentencias y unos 40 KB por transacción): 1,6 ms por transacción, unos 0,1 ms por sentencia, de 36 a 250 transacciones/s.
- La cola depende de la carga: el p99 agregado en PostgreSQL fue de 0,19 ms al 10% de la capacidad de la tarea, 1,34 ms al 30% y 2,71 ms al 50%. A 0,5 vCPU esa cola es sobre todo la espera de la cuota de CPU, no la evaluación: dimensiona para que la tarea trabaje cerca del 50% de su CPU.
- Costo y escala: unos 0,1 vCPU por cada 1.000 sentencias/s (0,105 en PostgreSQL, 0,097 en MySQL). Dos tareas de 0,5 vCPU sostuvieron 9.049 sentencias/s frente a 4.826/s de una, unas 1,9 veces, con la carga repartida por igual.
- Estable: el segundo día, en hosts nuevos, la mediana agregada se movió como mucho 0,03 ms hasta el 70% de la capacidad.
Son sentencias pequeñas: una sentencia más grande agrega más, y el barrido por tamaño todavía no se corrió en EC2 (ver Límites). Es una medición en estas condiciones, no una garantía.
Qué medimos y por qué
Un firewall SQL está en el camino de cada query: todo lo que tu aplicación envía lo atraviesa antes de llegar a la base. Su costo no es solo evaluar las reglas, que toma microsegundos dentro del proceso; es el salto completo: dos sesiones TLS, leer el protocolo, evaluar las reglas y enviar la telemetría. Eso es lo que medimos: la latencia que el proxy agrega frente a ir directo a la base, a tasas fijas, y la CPU que usa para hacerlo.
Tres números suelen mezclarse: la evaluación de reglas (microsegundos, dentro del proceso), la latencia agregada (lo que nota tu aplicación) y el throughput (cuánto carga una tarea antes de que su latencia se degrade). Esta página publica los dos últimos, cada uno con sus condiciones, y deja a la vista la cola (p99), no solo la mediana.
Configuración
| Componente | Configuración |
|---|---|
| Hosts | Sistema bajo prueba: c7g.2xlarge (8 núcleos Graviton3, sin SMT). Generador de carga: c7g.xlarge. Los dos en un cluster placement group en us-east-1a, en su propia VPC. Steal time de 0% en los dos hosts. |
| CPU | El proxy en su propio núcleo con una cuota CFS del 50% (0,5 vCPU, como una tarea de Fargate); el intermediario de referencia en otro núcleo con el mismo presupuesto; las bases en tres núcleos; el sistema y las interrupciones en el núcleo 0. |
| Proxy | vericto-proxy 4.14.2, imagen vericto/vericto-proxy@sha256:0446e435…85eb6b, motor 4.3.0, 42 reglas estándar con la política por defecto (critical y high bloquean, medium marca, low registra), modo enforce, telemetría completa hacia un plano de control local que responde al instante, RUST_LOG=info. |
| Bases de datos | PostgreSQL 17.6 y MySQL 8.4.11 en contenedores del sistema bajo prueba, sobre gp3, con la durabilidad activada (fsync, synchronous_commit, innodb_flush_log_at_trx_commit=1) y buffers más grandes que los datos. pgbench con escala 100 (10.000.000 de cuentas) y sysbench con 8 tablas de 1.000.000 de filas, verificados con checksum después de cargarlos. |
| TLS | En los dos tramos (cliente a proxy y proxy a base) en todas las celdas publicadas. |
| Cargas | PostgreSQL: pgbench select-only con el protocolo extendido, donde el proxy lee y evalúa cada ejecución. MySQL: sysbench oltp_read_only (10 lecturas por clave y 4 rangos dentro de una transacción: 16 sentencias, unos 40 KB de resultado), reproducido en lazo abierto sobre el protocolo de texto. |
| Referencias | Directo (cliente a base); HAProxy 3.0 en modo TCP, con el mismo núcleo y la misma cuota: el costo del salto por sí solo (reenvía la sesión TLS de punta a punta, así que no paga criptografía); y Vericto en modo enforce, como lo corren los clientes. |
| Harness | vericto-bench (Apache-2.0), commit 40d69b8bbb01 el día 1; cada imagen fijada por digest y la procedencia de cada host (kernel, AMI, THP, chrony, cgroups) registrada en el manifiesto de la corrida. |
Método
- Lazo abierto a tasa fija. La request i tiene su hora en
inicio + i/tasay la latencia se mide desde esa hora prevista, no desde que salió: una pausa cuenta contra cada request que debía salir durante ella (sin coordinated omission). pgbench-Rusa un calendario de Poisson y su retraso se suma a la latencia. Histogramas HdrHistogram con 3 cifras significativas, un intervalo cada 10 s. - Celdas. 60 s de calentamiento descartados y 300 s medidos, al 10, 30, 50, 70, 80, 90 y 100% de S, con las mismas tasas absolutas para cada destino. S es el máximo en lazo cerrado de Vericto enforce a 0,5 vCPU con TLS: 6.033 sentencias/s en PostgreSQL y 357 transacciones/s (5.706 sentencias/s) en MySQL.
- Repeticiones. 3 por tasa, intercaladas: cada destino corre a una tasa antes de pasar a la siguiente, en un orden de cuadrado latino balanceado con semilla. Las curvas principales se repitieron un segundo día en hosts recién creados, a las mismas tasas, con 1 repetición.
- Latencia agregada. En cada repetición, Vericto menos directo a la misma tasa y en la misma repetición, percentil por percentil; entre repeticiones, la media con un intervalo t de Student del 95%. Un intervalo que contiene el cero se publica como "no distinguible de la ruta directa", nunca como cero.
- Validez, sin descartar outliers. Una repetición solo es inválida por una razón registrada antes de correr (errores por encima del 0,1%, CPU del generador por encima del 70%, steal time por encima del 1%, celda no estable); se guarda en los datos crudos y se repite una vez. Una celda cuya tasa lograda cae por debajo del 99% de la ofrecida está saturada: cierra la curva y nunca se cita como latencia.
- Topes de tráfico. Cada interfaz se cuenta cada segundo; una celda se aborta por encima de 400 Mbps por componente o de 800 Mbps en total durante 3 segundos seguidos. Ninguna celda publicada en lazo abierto se abortó; en MySQL, los pasos en lazo cerrado de las referencias más rápidas sí llegaron al tope.
- Control del generador. Una vez por minuto, durante una celda en lazo abierto, la base se pausa un segundo: un generador honesto debe verlo en cerca del 1% de las requests. Lo vio en el 0,97% y el 0,95% (se esperaba el 0,83%).
- CPU. La CPU del contenedor del proxy (cgroup) cada segundo, y un ajuste lineal contra las sentencias/s que cargó, sobre las celdas en lazo abierto por debajo del 80% de S.
Resultados
Día 1, media de 3 repeticiones con su intervalo del 95%. La latencia publicada llega hasta el 70% de S: el día 2, en otro host, la celda del 80% de PostgreSQL ya no fue estable.
PostgreSQL: latencia agregada según la tasa
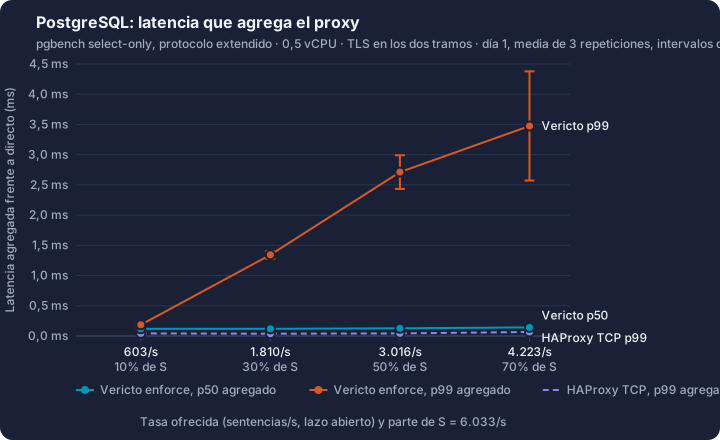
| Tasa ofrecida (sentencias/s) | Parte de S | Directo p50 / p99 (ms) | Vericto, p50 agregado [95%] (ms) | Vericto, p99 agregado [95%] (ms) | HAProxy, p50 / p99 agregados (ms) | CPU del proxy (vCPU) |
|---|---|---|---|---|---|---|
| 603 | 10% | 0,31 / 0,37 | 0,119 [0,115; 0,122] | 0,19 [0,18; 0,19] | 0,036 / 0,044 | 0,07 |
| 1.810 | 30% | 0,30 / 0,34 | 0,120 [0,114; 0,125] | 1,34 [1,28; 1,41] | 0,032 / 0,038 | 0,20 |
| 3.016 | 50% | 0,29 / 0,34 | 0,128 [0,117; 0,139] | 2,71 [2,43; 2,99] | 0,033 / 0,043 | 0,33 |
| 4.223 | 70% | 0,29 / 0,35 | 0,142 [0,132; 0,153] | 3,47 [2,57; 4,38] | 0,033 / 0,066 | 0,45 |
La mediana casi no se mueve con la carga (de 0,12 a 0,14 ms). El p99 sí: de 0,19 ms al 10% de S a 2,71 ms al 50% y 3,47 ms al 70%. HAProxy en modo TCP, con el mismo núcleo y la misma cuota, agregó de 0,03 a 0,04 ms en p50 y de 0,04 a 0,07 ms en p99: el salto por sí solo es barato. HAProxy reenvía la sesión TLS sin tocarla; el proxy termina y vuelve a abrir TLS en los dos tramos, lee el protocolo y evalúa las reglas. Cómo se reparte ese costo entre las partes está en la siguiente tanda.
MySQL: latencia agregada por transacción
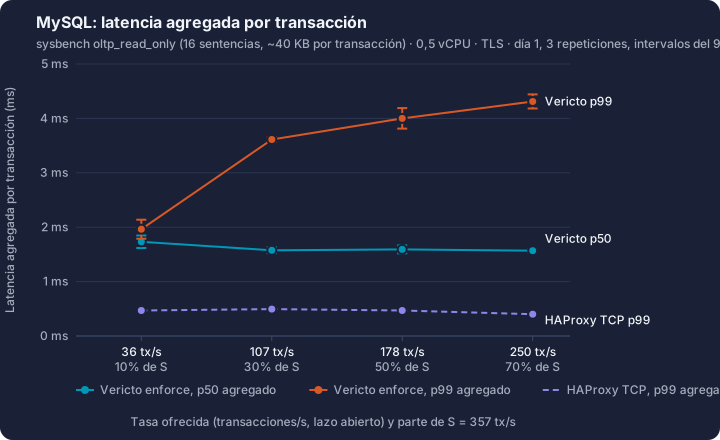
| Tasa ofrecida (transacciones/s) | Parte de S | Directo p50 / p99 por transacción (ms) | Vericto, p50 agregado por transacción [95%] (ms) | p50 agregado por sentencia (ms) | Vericto, p99 agregado por transacción [95%] (ms) | HAProxy, p50 / p99 agregados (ms) | CPU del proxy (vCPU) |
|---|---|---|---|---|---|---|---|
| 36 | 10% | 2,66 / 3,27 | 1,73 [1,62; 1,85] | 0,108 | 1,96 [1,79; 2,14] | 0,48 / 0,47 | 0,06 |
| 107 | 30% | 2,57 / 3,18 | 1,58 [1,52; 1,63] | 0,099 | 3,61 [3,57; 3,65] | 0,49 / 0,50 | 0,17 |
| 178 | 50% | 2,55 / 3,16 | 1,59 [1,52; 1,67] | 0,100 | 4,00 [3,81; 4,19] | 0,51 / 0,47 | 0,28 |
| 250 | 70% | 2,51 / 3,16 | 1,57 [1,54; 1,60] | 0,098 | 4,31 [4,18; 4,44] | 0,44 / 0,40 | 0,39 |
Por transacción de 16 sentencias, el proxy agregó de 1,57 a 1,73 ms en la mediana, unos 0,1 ms por sentencia, sin cambios del 10 al 70% de S. El p99 fue de 1,96 ms al 10% y de 3,6 a 4,3 ms del 30 al 70%. HAProxy agregó de 0,44 a 0,51 ms por transacción: cada transacción devuelve unos 40 KB, que todo intermediario tiene que reenviar.
CPU según el throughput
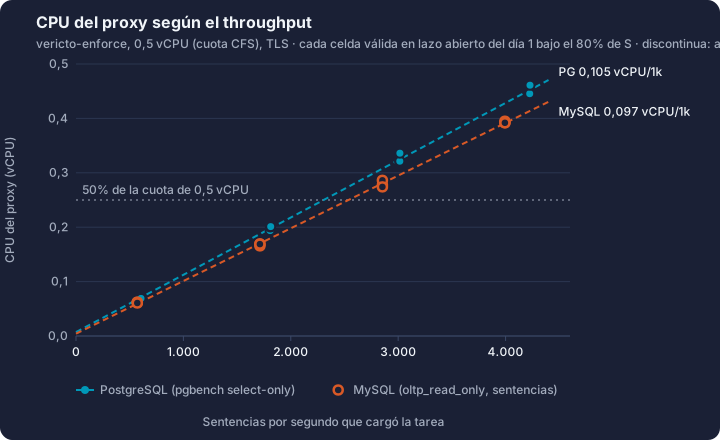
| Carga | vCPU por cada 1.000 sentencias/s [95%] | Celdas | USD al mes por cada 1.000 sentencias/s, al 70% de uso |
|---|---|---|---|
| PostgreSQL (pgbench select-only) | 0,105 [0,103; 0,108] | 12 | 3,56 |
| MySQL (oltp_read_only, por sentencia) | 0,097 [0,095; 0,099] | 12 | 3,27 |
El costo es lineal: unos 0,1 vCPU por cada 1.000 sentencias/s en los dos motores, desde casi cero. Al precio de lista de Fargate ARM64 (USD 0,03238 por vCPU-hora) y con un objetivo de uso del 70%, son unos USD 3,6 (PostgreSQL) y 3,3 (MySQL) al mes por cada 1.000 sentencias/s.
Una tarea o dos
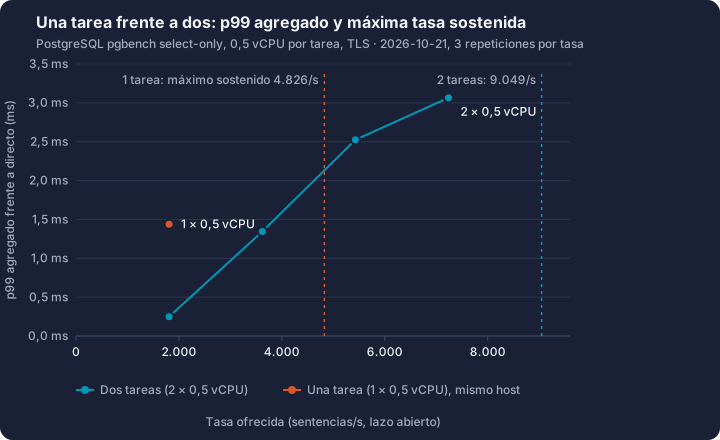
| Proxy | Tasa ofrecida (sentencias/s) | Lograda (sentencias/s) | p50 agregado (ms) | p99 agregado (ms) | vCPU por tarea (1 / 2) |
|---|---|---|---|---|---|
| 1 × 0,5 vCPU | 1.810 | 1.807 | 0,12 | 1,44 | 0,20 |
| 2 × 0,5 vCPU | 1.810 | 1.807 | 0,12 | 0,25 | 0,11 / 0,10 |
| 2 × 0,5 vCPU | 3.620 | 3.611 | 0,12 | 1,34 | 0,19 / 0,20 |
| 1 × 0,5 vCPU | 5.429 | saturado (3 de 3); 4.732/s logrados | – | – | 0,50 |
| 2 × 0,5 vCPU | 5.429 | 5.424 | 0,12 | 2,52 | 0,31 / 0,27 |
| 1 × 0,5 vCPU | 7.239 | saturado (3 de 3); 2.903/s logrados | – | – | 0,50 |
| 2 × 0,5 vCPU | 7.239 | 7.231 | 0,14 | 3,07 | 0,38 / 0,38 |
| 2 × 0,5 vCPU | 10.859 | saturado (3 de 3); 10.443/s logrados | – | – | 0,50 / 0,50 |
| 2 × 0,5 vCPU | 13.272 | saturado (3 de 3); 9.341/s logrados | – | – | 0,50 / 0,50 |
| 2 × 0,5 vCPU | 9.049 | 9.040 (el máximo sostenido) | no se publica | no se publica (el intervalo cruza el cero) | 0,44 / 0,48 |
En staging, dos tareas habían saturado por debajo de la curva de una; en EC2 eso no se reproduce. Dos tareas sostuvieron 9.049 sentencias/s frente a 4.826/s de una (la celda del 80% de la curva del día 1), unas 1,9 veces, con la carga repartida por igual (0,44 y 0,48 vCPU). A la misma tasa, dos tareas bajaron el p99 agregado de 1,44 a 0,25 ms (1.810/s), porque cada una trabaja con la mitad de presión sobre su cuota. Con una tarea, el mismo host saturó a 5.429/s.
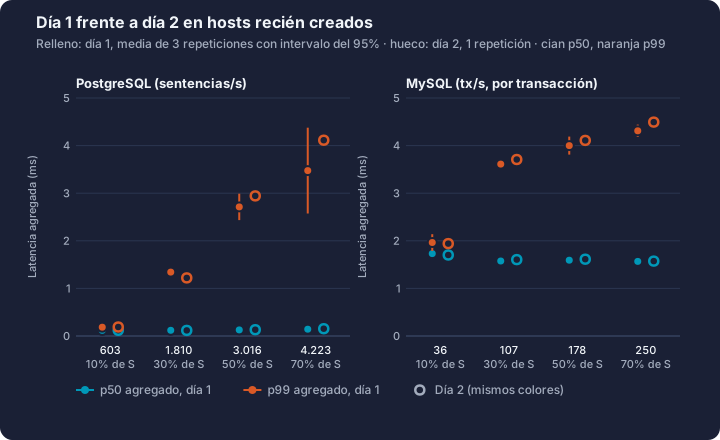
Día 1 frente a día 2
| Curva y tasa | Parte de S | Día 1, p50 / p99 agregados (ms) | Día 2, p50 / p99 agregados (ms) | Diferencia p50 / p99 (ms) |
|---|---|---|---|---|
| PostgreSQL, 603/s | 10% | 0,119 / 0,19 | 0,120 / 0,19 | 0,001 / 0,00 |
| PostgreSQL, 1.810/s | 30% | 0,120 / 1,34 | 0,117 / 1,22 | −0,003 / −0,12 |
| PostgreSQL, 3.016/s | 50% | 0,128 / 2,71 | 0,133 / 2,94 | 0,005 / 0,23 |
| PostgreSQL, 4.223/s | 70% | 0,142 / 3,47 | 0,154 / 4,11 | 0,012 / 0,64 |
| MySQL, 36 tx/s | 10% | 1,732 / 1,96 | 1,702 / 1,94 | −0,030 / −0,02 |
| MySQL, 107 tx/s | 30% | 1,576 / 3,61 | 1,606 / 3,71 | 0,030 / 0,10 |
| MySQL, 178 tx/s | 50% | 1,593 / 4,00 | 1,614 / 4,11 | 0,021 / 0,11 |
| MySQL, 250 tx/s | 70% | 1,568 / 4,31 | 1,574 / 4,49 | 0,006 / 0,18 |
Hasta el 70% de S, la mediana agregada se movió como mucho 0,012 ms en PostgreSQL y 0,030 ms en MySQL entre días y hosts; el p99, como mucho 0,64 ms (PostgreSQL al 70%, dentro del intervalo del día 1) y 0,18 ms en MySQL. En el host del día 2, la celda del 80% de PostgreSQL no fue estable (el codo llegó antes), por eso las cifras publicadas se detienen en el 70% de S.
Cómo leerlo y dimensionar
- Presupuesta unos 0,1 vCPU por cada 1.000 sentencias/s. En la prueba, 1.810 sentencias/s usaron 0,20 vCPU, el 40% de la cuota de una tarea de 0,5 vCPU.
- Escala hacia afuera cerca del 50% de CPU. El p99 crece con la carga sobre la cuota: 0,19 ms con la tarea al 14% de su CPU (603/s), 1,34 ms al 40% (1.810/s), 2,71 ms al 65% (3.016/s) y 3,47 ms al 90% (4.223/s). Sumar una tarea reparte la presión: con dos tareas, a 1.810/s el p99 fue de 0,25 ms.
- Por qué sube la cola con una cuota chica. 0,5 vCPU es una cuota CFS: la tarea puede usar la mitad de cada período de planificación. Cuando una ráfaga agota la cuota temprano, cada sentencia que llega después espera al período siguiente, por rápido que sea el proxy. La mediana no lo ve; el p99 sí, y más cuanto más ocupada está la tarea. La curva a 1 vCPU, que separa esas esperas del costo propio del proxy, está en la siguiente tanda.
- Despliega el proxy cerca de la base. Aquí el tramo del proxy a la base está en el mismo host; en una VPC, cada salto de red suma su propio viaje de ida y vuelta. Pon el proxy en la misma zona de disponibilidad que la base.
- Mídelo con tu tráfico. Cada evento del audit trail guarda la latencia de su evaluación (
latency_ms), así que puedes comparar estas cifras con las tuyas.
Límites
- No es staging. Las cifras salen de EC2 dedicado. Las sesiones en staging (Fargate detrás de un NLB y Aurora, dentro de una VPC) son contexto y no son la cifra principal. Una sola familia de instancias (Graviton3): la verificación cruzada en Intel quedó fuera por presupuesto.
- Solo sentencias pequeñas. Una lectura por clave en PostgreSQL y una transacción de lectura de 16 sentencias en MySQL. Lo agregado crece con el tamaño de la sentencia; el barrido por tamaño está en la siguiente tanda, y hasta entonces la referencia es la curva de staging de más abajo.
- Todavía no se corrió (siguiente tanda): el barrido por tamaño de sentencia, los resultados grandes y las columnas enmascaradas, los modos observe y offline en lazo abierto, 1 vCPU, las referencias PgBouncer y ProxySQL, TLS desactivado, tpcb-like y los otros modos de protocolo, la mezcla tipo ORM, las sentencias bloqueadas y el establecimiento de conexiones.
- MySQL a tasas altas está limitado por el tope de tráfico, no por el proxy: con unos 40 KB por transacción, los máximos en lazo cerrado de las referencias más rápidas pasan los 400 Mbps, y esos pasos se abortaron a propósito.
- El entorno es más amable que el tuyo en dos puntos: el tramo a la base es local, y el plano de control de prueba responde al instante (el costo de ingesta del backend no se mide aquí). Solo las reglas estándar: sin reglas propias, allowlists ni enmascarado.
- El día 2 tiene 1 repetición por celda: prueba la estabilidad, no achica los intervalos. Las celdas del día 1 compartieron el generador con ráfagas de un segundo de la sincronización de progreso del harness (corregido para las corridas siguientes; el día 2 coincide con el día 1). Cada celda dura 5 minutos: el crecimiento de memoria durante horas no está cubierto.
Reprodúcelo
El harness es vericto-bench (Apache-2.0): el Terraform de los dos hosts, el runner, las suites, el análisis y el reporte que produjo cada tabla de esta página. Cualquiera puede correrlo en su propia cuenta de AWS, sin el backend de Vericto; la campaña completa costó unos USD 18 a precios de lista.
Código: github.com/vericto/vericto-bench. Resultados de esta campaña (manifiestos, celdas, reportes, gráficos y checksums SHA-256): results/bench-2026-11.
Datos crudos
Los histogramas por intervalo, los logs por transacción de pgbench, los contadores de CPU y de tráfico y los logs del proxy: 3,9 GB, guardados con sus checksums SHA-256. Están disponibles a pedido en contacto hasta que se publiquen junto con el repositorio.
Mediciones anteriores en staging (contexto)
Antes de esta corrida, en staging el 16 de octubre de 2026 (vericto-proxy 4.12.0 en una tarea Fargate ARM64 de 0,25 vCPU, Aurora Serverless v2, TLS, modo enforce, mezcla tipo ORM), medimos lo que BENCH-2026-11 todavía no cubre. Son contexto, no cifras principales:
- Tamaño de la sentencia: en PostgreSQL, un INSERT de 10 filas agregó 0,58 ms en p50; de 100 filas, 1,05 ms, ya por encima del milisegundo; de 500, 3,07 ms; de 1.000, 5,54 ms.
- Solo la evaluación de reglas, sin red: p99 de 100 µs o menos para las sentencias OLTP (vericto-engine 3.9.0).
- Telemetría: 0 eventos perdidos de los 1.222.254 enviados al plano de control durante la sesión.